Arbitrer coût et performance entre modèles IA, avec Gemini en exemple
31 mai 2026
Pour savoir si une tâche peut passer sur un modèle moins cher, tu mesures : tu rejoues 50 à 100 cas réels sur les deux modèles avec le même prompt, et tu compares le taux de bonnes réponses au coût. Sur la gamme Gemini, l'écart de prix va de 2,7 à 25 fois selon le modèle léger choisi (prix du 1er novembre 2026).
Exemple fictif, que je garde d'un bout à l'autre : un freelance a branché sur la boutique d'un client un tri automatique des emails de support. Le tri tourne sur le modèle phare choisi le jour de la mise en ligne, personne n'y est revenu, et la facture API du client ne baisse jamais. Il paie le tarif premium pour décider si un email parle d'une facture ou non, une tâche qui ne demande pas le meilleur modèle du marché.
En bref
- Pour qui
- Freelances et petites agences qui ont branché un modèle IA dans un produit et veulent alléger la facture sans perdre en qualité
- Il te faut
- La liste de tes tâches IA et 50 à 100 cas réels dont tu connais la bonne réponse
- Temps
- Une demi-journée par tâche (mon estimation)
- Coût
- Selon ton usage (quelques appels d'API pour les tests)
- Niveau
- Intermédiaire
- Mis à jour le
- 1 novembre 2026
Deux réflexes coûtent de l'argent. Le réflexe naïf : tout basculer sur le modèle le moins cher. Le réflexe paresseux : tout laisser sur le plus gros « pour être sûr ». Ce tuto te donne la méthode pour trancher tâche par tâche, avec des critères et un protocole de test, sans deviner.
Comprendre ce que tu paies vraiment
Avant d'arbitrer, il faut un ordre de grandeur honnête. Les prix bougent vite, mais la structure ne change pas : un modèle se facture au million de tokens, séparément en entrée (ce que tu envoies) et en sortie (ce qu'il génère, réflexion comprise), et la sortie coûte plus cher que l'entrée.
Je prends la gamme Gemini parce qu'elle montre bien l'écart. Voici les prix par million de tokens, en tarif standard payant, d'après la page officielle des tarifs Google (page lue le 1er novembre 2026) :
| Modèle | Entrée | Sortie |
|---|---|---|
| Gemini 4 Argon | 2 $ | 10 $ |
| Gemini 3.8 Flash | 0,75 $ | 3,75 $ |
| Gemini 3.5 Flash-Lite | 0,30 $ | 2,50 $ |
| Gemini 2.5 Flash-Lite (texte) | 0,10 $ | 0,40 $ |
Les rapports se lisent sur la table. Entre Gemini 4 Argon et Gemini 3.8 Flash, l'entrée et la sortie coûtent 2,7 fois moins. Face à Gemini 3.5 Flash-Lite, c'est 6,7 fois moins en entrée et 4 fois moins en sortie. Face à Gemini 2.5 Flash-Lite, c'est 20 fois moins en entrée et 25 fois moins en sortie.
Fais le calcul sur la tâche du freelance. Classer un email de support, c'est environ 500 tokens en entrée et 10 en sortie (des valeurs d'exemple). À 300 emails par jour, sur 30 jours, cela fait 4,5 millions de tokens d'entrée et 90 000 de sortie par mois :
- Sur Gemini 4 Argon : 9,90 $ par mois.
- Sur Gemini 3.8 Flash : environ 3,71 $.
- Sur Gemini 3.5 Flash-Lite : environ 1,58 $.
- Sur Gemini 2.5 Flash-Lite : environ 0,49 $.
Entre le premier et le dernier, un facteur d'environ 20 pour la même tâche, et d'environ 40 une fois le tarif d'Argon passé à 4 $ / 20 $. À ce volume, l'économie reste d'environ 9 $ par mois : pour cette tâche, la bascule se joue autant sur la qualité que sur la facture. Avec 100 fois plus d'emails (30 000 par jour), le même calcul donne environ 940 $ par mois. Un classifieur n'a pas besoin de raisonner, il doit coller la bonne étiquette, à condition que la qualité tienne : la suite te montre comment le vérifier.
Regarde aussi le prix de sortie. Sur les tâches génératives (rédaction, résumé, réponse client), la sortie fait l'essentiel de la facture. Sur ces quatre modèles, elle coûte de 4 à 8,3 fois l'entrée.
Cartographier tes tâches IA avant de toucher au modèle
Tu ne peux pas arbitrer ce que tu n'as pas listé. La première étape n'a rien de technique : c'est un inventaire. Ouvre un tableau et liste chaque endroit où un modèle IA tourne dans ton activité, ou dans celle de ton client. Pour chacun, note trois choses.
D'abord, le volume : combien de fois par jour la tâche s'exécute. Une tâche qui tourne 5 fois par mois ne mérite pas une heure d'optimisation. Une qui tourne 10 000 fois par jour mérite un regard attentif.
Ensuite, la nature de la tâche. Range chaque usage dans une famille, parce que la famille décide presque tout :
- Extraction et classification : sortir une info structurée, coller une étiquette, répondre par oui ou non. Peu de créativité, réponse vérifiable.
- Transformation : reformuler, traduire, résumer, changer de format. Le sens est donné, le modèle le réarrange.
- Génération simple : écrire un email court, une description produit, une réponse type. De la création, cadrée par un brief précis.
- Raisonnement : analyser une situation, comparer des options, écrire du code non trivial, suivre une longue chaîne logique. C'est là que le gros modèle gagne le plus souvent.
Enfin, la tolérance à l'erreur. Une erreur sur un tri interne se rattrape en 10 secondes. Une erreur sur un devis envoyé au client se paie en réputation. Une tâche à fort volume et faible tolérance demande plus de prudence qu'une tâche à fort volume et forte tolérance.
Avec ces trois colonnes, les candidats apparaissent. Les tâches d'extraction et de transformation à fort volume sont souvent migrables vers un modèle léger. Les tâches de raisonnement à fort enjeu restent sur le gros modèle. Le vrai travail d'arbitrage se joue entre les deux.
Les critères de bascule : quand descendre de gamme
Une fois tes tâches cartographiées, quatre signaux disent « celle-là, tu peux la basculer ».
La tâche a une réponse vérifiable. Si tu peux dire objectivement que la sortie est juste ou fausse (la bonne étiquette, la bonne date extraite, le bon format JSON), un modèle léger a de bonnes chances de faire le travail. Le gros modèle se justifie quand la « bonne réponse » demande du jugement.
La sortie est courte et contrainte. Choisir dans une liste fermée, remplir un schéma, répondre par oui ou non. Plus la sortie est cadrée, moins la puissance de raisonnement compte, et plus l'écart de qualité tend à s'effacer.
Le contexte est limité. Si la tâche tient dans quelques milliers de tokens et ne demande pas de garder un dossier de 100 pages en tête, un modèle léger a plus de chances de suivre. Les très longs contextes et les longues chaînes de raisonnement sont l'endroit où les gros modèles gardent le plus souvent l'avantage : vérifie-le avec ton jeu de test.
Le volume justifie l'effort. Migrer une tâche coûte du temps de test et de recalibrage. Sous un certain volume, l'économie ne paie pas l'effort. Au-dessus, chaque jour passé sur l'ancien modèle coûte de l'argent pour rien.
À l'inverse, garde sur le gros modèle le raisonnement en plusieurs étapes, l'analyse de cas ambigus, le code complexe, et tout livrable qui part directement chez un client sans relecture. Le surcoût y est faible parce que le volume l'est, et l'erreur y coûte cher.
Une nuance sur les versions : un modèle plus récent n'est pas toujours moins cher. Sur la page Google, Gemini 3.5 Flash-Lite coûte 0,30 $ / 2,50 $, contre 0,10 $ / 0,40 $ pour Gemini 2.5 Flash-Lite : 3 fois plus en entrée et 6,25 fois plus en sortie. La logique « plus récent donc à adopter » est fausse quand tu optimises un coût. Tu montes vers le modèle récent pour gagner en qualité ou en vitesse, tu descends vers un modèle plus ancien ou plus léger pour payer moins. Ce sont deux décisions opposées, ne les confonds pas.
Comment tester une bascule sans risque
La bascule ne se décide pas en lisant un benchmark public. Un benchmark te dit comment un modèle se comporte sur des tâches génériques. Toi, tu as besoin de savoir comment il se comporte sur ta tâche, avec tes données. Voici le protocole, en quatre temps.
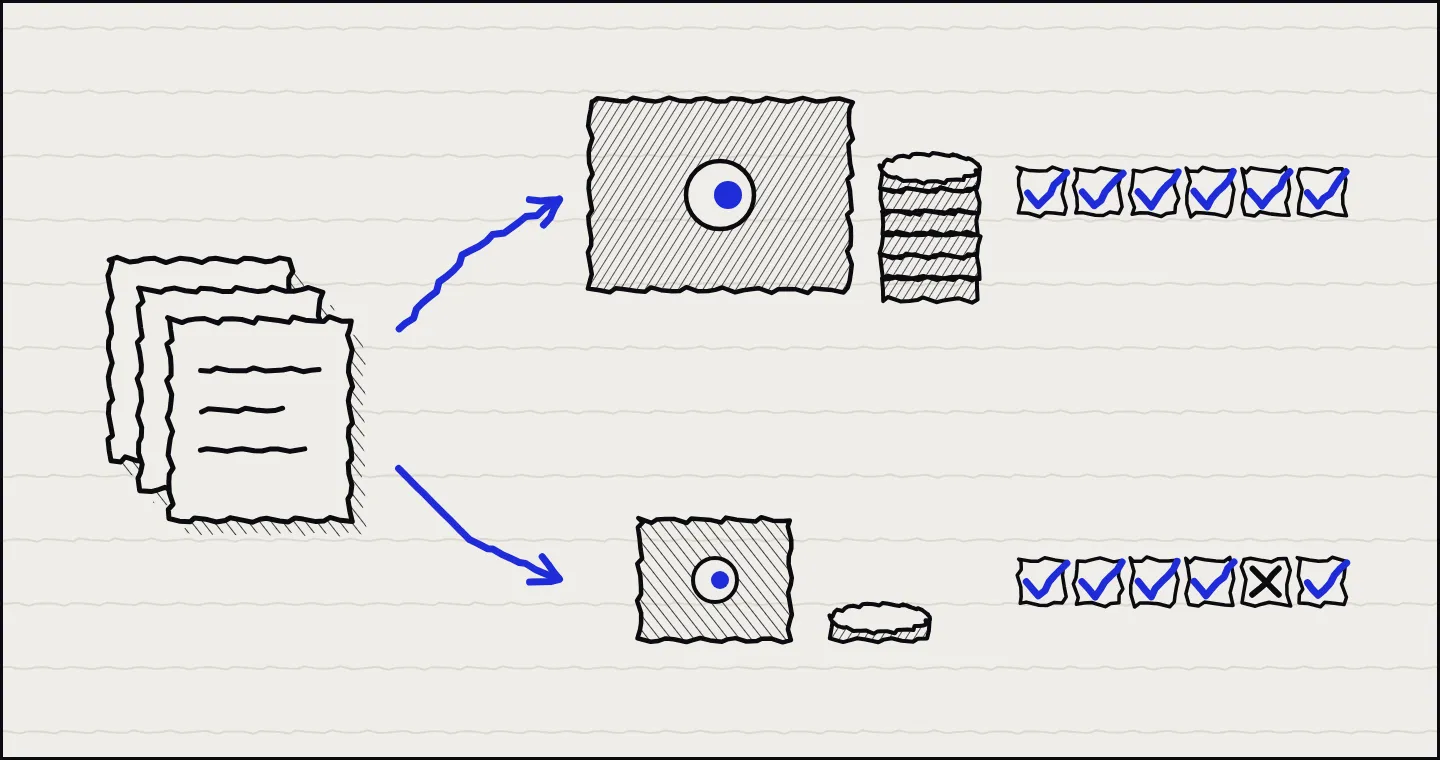
Constitue un jeu de test représentatif. Prends 50 à 100 cas réels passés par ta tâche, avec la bonne réponse connue. Pour une classification, ce sont des entrées déjà étiquetées correctement. Pour une extraction, des documents dont tu connais le contenu attendu. Si les données viennent d'un client, anonymise-les. Ce jeu est ta vérité terrain, il ne change pas entre deux tests.
Fais tourner les deux modèles sur le même jeu. Le modèle actuel et le candidat plus léger, avec exactement le même prompt et les mêmes entrées. Tu obtiens deux colonnes de sorties à comparer.
Mesure l'écart sur ta métrique, pas sur une impression. Pour une tâche vérifiable, compte le taux de réponses correctes de chaque modèle. Si le gros modèle est à 94 % et le léger à 91 % (chiffres d'exemple), la question devient simple : est-ce que 3 points de précision valent l'écart de prix, vu ta tolérance à l'erreur sur cette tâche précise ? Parfois la réponse est non et tu bascules. Parfois elle est oui et tu gardes le gros modèle en sachant pourquoi.
Recalibre le prompt avant de conclure. Un modèle léger qui échoue avec le prompt du gros modèle réussit parfois avec un prompt mieux taillé pour lui : deux ou trois exemples ajoutés, un format imposé plus strictement. Avant de déclarer un modèle « pas assez bon », donne-lui le prompt qu'il mérite. Beaucoup de bascules ratées sont des prompts qu'on n'a pas pris le temps d'adapter.
Compte une demi-journée par tâche (mon estimation). La décision que ce test éclaire se rejoue ensuite à chaque requête, donc le temps passé se rembourse d'autant plus vite que le volume est élevé.
La table de décision
Une fois tes tâches mesurées, ramène tout à une grille simple. C'est un point de départ à adapter à ton contexte et à tes mesures.
| Type de tâche | Volume | Tolérance erreur | Modèle conseillé | Pourquoi |
|---|---|---|---|---|
| Classification, extraction | Élevé | Moyenne à haute | Flash-Lite | Réponse vérifiable, sortie courte, l'écart de qualité tend à s'effacer |
| Transformation (résumé, traduction, format) | Élevé | Moyenne | Flash standard | Sens donné, le modèle réarrange, bon rapport qualité prix |
| Génération courte cadrée (email type, fiche produit) | Moyen à élevé | Moyenne | Flash standard | Création bornée par le brief, relecture légère |
| Génération à enjeu (devis, réponse à un dirigeant) | Faible | Faible | Gros modèle | Volume faible donc surcoût limité, erreur coûteuse |
| Raisonnement, analyse, code non trivial | Faible à moyen | Faible | Gros modèle | Le raisonnement est ce qui justifie le tarif premium |
| Long contexte (dossier de 100 pages) | Variable | Variable | Gros modèle | À confirmer avec ton jeu de test |
La logique tient en une phrase : plus la tâche est vérifiable, courte et tolérante, plus tu peux descendre en gamme. Plus elle demande du jugement, du contexte long ou ne pardonne pas l'erreur, plus le gros modèle se justifie. Le volume joue le rôle de multiplicateur : il transforme une petite économie par requête en gros montant mensuel, donc il décide où investir ton temps d'arbitrage.
Architecturer pour pouvoir changer d'avis
La meilleure décision d'aujourd'hui sera périmée dans quelques mois : les modèles changent et les prix bougent, la page Google l'illustre avec ses tarifs qui changent de date en date. La vraie protection n'est pas de choisir le bon modèle une fois, c'est de pouvoir en changer sans réécrire ton système.
Ne code jamais en dur le nom du modèle au milieu de ta logique métier. Sors-le dans une configuration, par type de tâche :
MODELES = {
    "classification": "gemini-2.5-flash-lite",  # exemple : remplace par le modèle qui réussit ton jeu de test
    "generation": "gemini-3.8-flash",
    "raisonnement": "gemini-4-argon",
}
Le jour où un nouveau modèle sort moins cher et aussi bon, tu changes une ligne et tu relances ton jeu de test. Le jour où un fournisseur augmente ses prix, tu compares en une après-midi au lieu d'une semaine.
Cette discipline rend l'arbitrage continu au lieu de ponctuel. Une fois ton jeu de test constitué et ton modèle paramétrable, réévaluer une bascule prend une demi-journée, pas un projet. Tu peux le refaire à chaque sortie de modèle qui te concerne et garder le meilleur rapport qualité prix.
Checklist finale
0 sur 6
Et maintenant ?
Arbitrer coût et performance entre modèles, c'est une décision de gestion qui touche ta marge, ou celle de ton client, et qui se rejoue à chaque requête que le modèle traite. Si tu n'as pas encore listé ce que tu automatises, pars de la liste des 12 automatisations IA et par où commencer, puis reviens choisir le bon modèle pour chacune. Le coût d'un projet IA ne s'arrête pas à la ligne d'API non plus : les trois coûts cachés d'un projet IA complètent le tableau.
La suite logique, c'est de faire le même exercice côté Claude : maîtriser le coût des tokens Claude, avec le niveau d'effort, le cache et les lots. Je publie ce genre de méthode dans ma newsletter, tu peux t'inscrire juste en dessous.