
Maîtriser le coût des tokens Claude : régler le niveau de réflexion pour piloter ta facture API
31 mai 2026
Pour baisser une facture Claude sans abîmer la qualité, tu règles six choses : tu mesures chaque appel, tu baisses le niveau d'effort, tu envoies chaque tâche au bon modèle, tu mets les consignes répétées en cache, tu passes le non-urgent en lots, tu élagues le contexte. Chaque prix cité est lié à la page officielle, avec la date du relevé.
Exemple fictif, que je garde d'un bout à l'autre : une agence de trois personnes livre à un client un assistant qui répond aux emails de support, branché sur l'API Claude. Le premier mois, la facture dépasse largement le budget prévu. Personne ne sait quelle fonction consomme, et l'assistant appelle le même modèle sur chaque email, même pour reformuler une ligne.
En bref
- Pour qui
- Freelances et petites agences qui ont branché l'API Claude dans leur produit ou dans celui d'un client
- Il te faut
- Un compte API Anthropic et l'accès au code qui appelle Claude
- Temps
- Une heure ou deux pour mesurer et régler l'effort, une demi-journée pour le routage (mon estimation)
- Coût
- Aucun outil à payer en plus de l'API
- Niveau
- Intermédiaire
- Mis à jour le
- 1 novembre 2026
Le levier le plus mal compris est le niveau de réflexion : combien Claude « pense » avant de répondre. Ce temps de réflexion se paie, et il se règle. Les six leviers sont numérotés de 1 à 6 : en pratique, tu commences par le 6, la mesure, puis tu passes aux leviers 1 et 2. Chacun vient avec le problème, la marche à suivre et un calcul que tu peux refaire sur ta propre charge.
Régler le niveau de réflexion : le levier numéro un
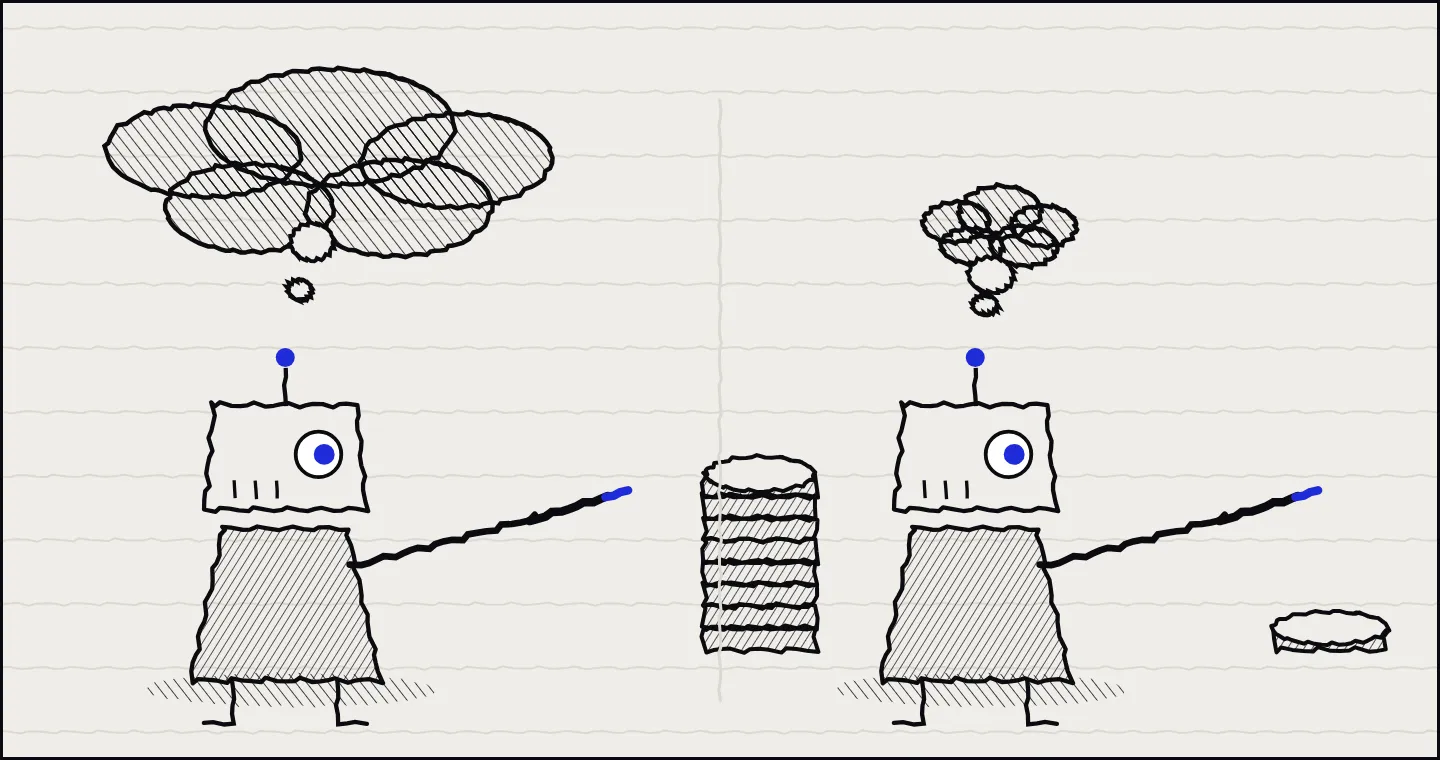
Le piège, c'est de laisser le modèle réfléchir au maximum partout, « au cas où ». Claude décide lui-même, requête par requête, s'il réfléchit et combien (c'est la réflexion adaptative). Chaque token de réflexion est facturé comme de la sortie. Un modèle qui réfléchit 8 000 tokens pour reformuler une phrase te coûte 8 000 tokens de sortie pour rien.
Ce que tu règles, c'est le niveau d'effort, avec cinq valeurs : low, medium, high, xhigh et max. Plus le niveau est bas, moins Claude réfléchit, et moins l'appel coûte. D'après la page effort, le niveau par défaut est high sur la plupart des modèles, dont Sonnet 5.5, et medium sur Opus 5.5 et Haiku 5.5. Si tu ne règles rien sur Sonnet 5.5, tu paies donc high. Le paramètre se place dans output_config, pas dans l'objet thinking :
import anthropic

client = anthropic.Anthropic()  # la clé est lue dans la variable d'environnement ANTHROPIC_API_KEY

response = client.messages.create(
    model="claude-sonnet-5-5",
    max_tokens=16000,  # la réflexion compte dans max_tokens : laisse de la place
    thinking={"type": "adaptive"},
    output_config={"effort": "medium"},  # low, medium, high, xhigh ou max : plus bas = pense moins = moins cher
    messages=[{"role": "user", "content": "[ta requête]"}],
)
print(response.usage)
L'effort est un conseil donné au modèle, pas un budget en tokens : à un niveau bas, Claude réfléchit encore sur un problème vraiment difficile, mais moins. Pour un chat ou tout usage sensible à la latence, la doc recommande de commencer à medium ou low sur Sonnet 5.5. Tu montes pour les requêtes complexes, et tu vérifies sur tes propres cas que la qualité tient.
Depuis Claude 4.7, les modèles refusent l'ancien réglage par budget fixe (thinking.type: "enabled" avec budget_tokens) et renvoient une erreur 400, d'après la page extended thinking. Cette page le marque comme déprécié. Il reste utilisable sur d'anciens modèles comme Sonnet 4.6 ou Haiku 4.5, où tu fixes toi-même le plafond :
response = client.messages.create(
    model="claude-sonnet-4-6",
    max_tokens=8000,
    thinking={"type": "enabled", "budget_tokens": 4000},
    messages=[{"role": "user", "content": "[ta requête]"}],
)
Le conseil d'Anthropic pour ce réglage : pour une tâche simple, partir près du minimum de 1 024 tokens, pour une tâche complexe de 16 000 ou plus, puis ajuster selon la latence et la qualité. Au-delà de 32 000 tokens, la doc conseille le traitement par lots : les requêtes longues risquent des timeouts.
Dans l'exemple de l'agence, l'assistant tourne sur Sonnet 5.5 sans réglage, donc à high. Les emails de support courts sont le premier endroit où tester medium, puis low.
Choisir le bon modèle pour chaque tâche
L'erreur la plus chère : tout faire tourner sur le modèle le plus puissant. Opus est excellent sur le raisonnement difficile, mais le payer pour classer un ticket de support ou extraire une date d'un PDF, c'est payer le tarif premium pour un travail que les modèles plus légers savent faire.
Voici les tarifs par million de tokens, relevés le 1er novembre 2026 sur la page officielle des prix :
| Modèle | Entrée | Sortie | Lecture du cache |
|---|---|---|---|
| Claude Haiku 5.5 | 0,10 $ | 0,50 $ | 0,01 $ |
| Claude Sonnet 5.5 | 2 $ | 10 $ | 0,10 $ |
| Claude Opus 5.5 | 4 $ | 20 $ | 0,20 $ |
Pour Haiku 5.5, ces prix valent pour les prompts jusqu'à 100 000 tokens. Au-delà, la page affiche 0,50 $ en entrée et 2,50 $ en sortie. Les modèles de la génération précédente restent listés et coûtent plus cher que leur remplaçant : Opus 4.8 à 5 $ / 25 $, Sonnet 4.6 à 3 $ / 15 $, Haiku 4.5 à 1 $ / 5 $. La page précise que les modèles à partir de Claude 4.7 produisent environ 30 % de tokens en plus pour le même texte : compare le coût de vrais appels, pas seulement le prix au million.
Les rapports se calculent sur la table. De Opus 5.5 à Sonnet 5.5, l'entrée comme la sortie coûtent 2 fois moins. De Opus 5.5 à Haiku 5.5, elles coûtent 40 fois moins. Si 70 % de tes requêtes quittent Opus 5.5 pour Sonnet 5.5 et que toutes ont la même taille, ta facture baisse de 35 %. Vers Haiku 5.5, elle baisse d'environ 68 %. C'est un calcul sur la grille de prix, pas une mesure de ta charge : le niveau d'effort par défaut n'est pas le même (high sur Sonnet 5.5, medium sur Opus 5.5), donc les tokens de sortie ne seront pas identiques d'un modèle à l'autre. Mesure sur de vrais appels.
Pour répartir les appels, segmente par complexité réelle :
- Haiku pour le volume simple. La doc le présente pour la classification, l'extraction et le routage.
- Sonnet pour le gros de la production : rédaction, synthèse, support client.
- Opus pour le raisonnement difficile, quand une erreur coûte cher.
Concrètement, tu mets un petit routeur en amont : une première règle simple (longueur, type de tâche, mot-clé) qui envoie chaque requête vers le bon modèle. Tu peux aussi utiliser Haiku comme classifieur de routage : à 0,10 $ le million de tokens en entrée, une requête de 500 tokens coûte 0,00005 $ à classer.
Activer le cache de prompt (prompt caching)
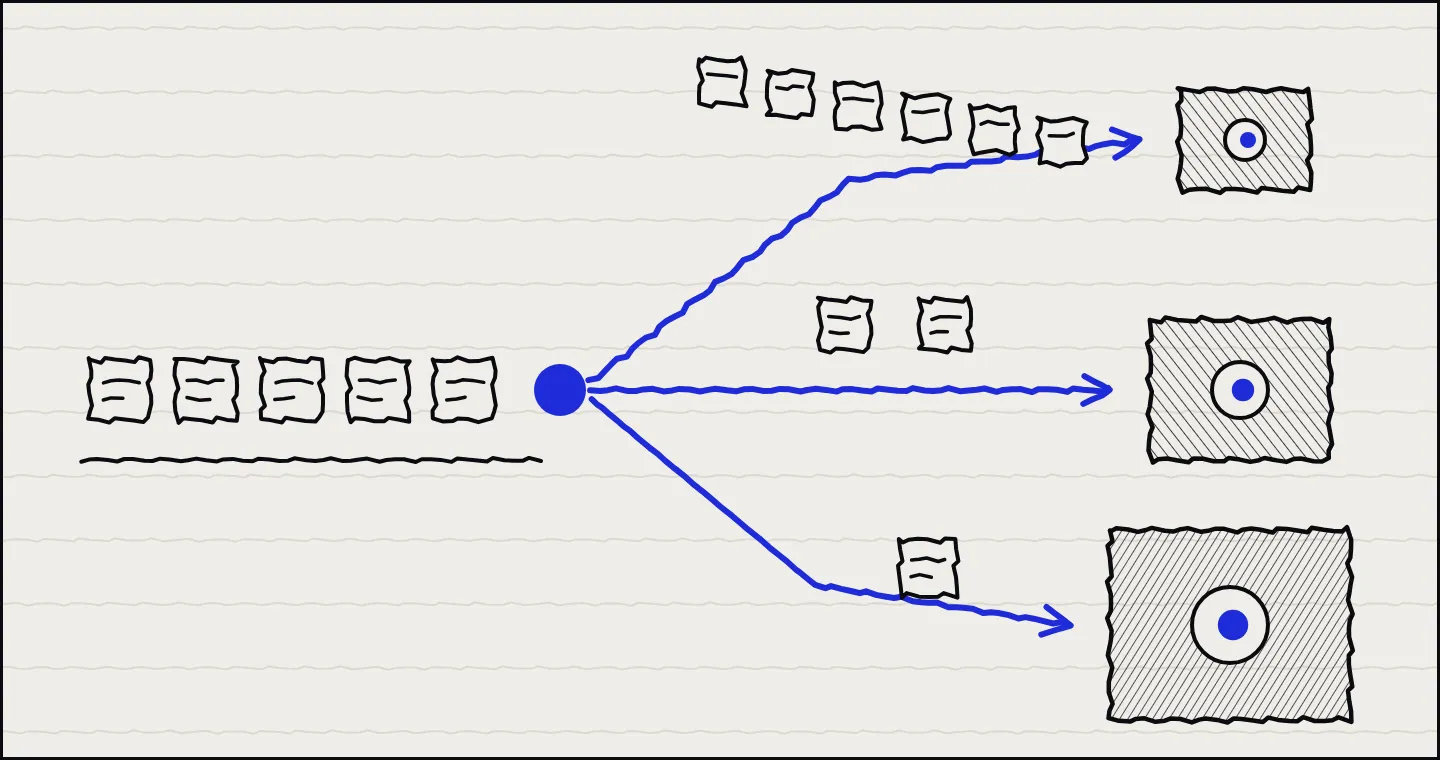
Si tu renvoies à chaque appel le même gros bloc (consignes système, documentation produit, exemples, historique de conversation), tu le fais retraiter en entier et tu le paies plein tarif à chaque fois. C'est de l'argent dépensé sur un contenu identique.
Tu marques la partie stable de ton prompt comme cachable. L'API la garde et la relit ensuite à prix réduit. Les multiplicateurs de la page des prix :
- Écriture du cache (5 minutes) : 1,25 fois le prix d'entrée de base.
- Écriture du cache (1 heure) : 2 fois le prix d'entrée.
- Lecture du cache : 0,1 fois le prix d'entrée, et 0,05 fois sur Opus 5.5 et Sonnet 5.5.
La page précise que le cache de 5 minutes est rentabilisé dès la première relecture, celui d'une heure dès la deuxième. Un exemple de calcul sur Sonnet 5.5 : 20 000 tokens de consignes coûtent 0,04 $ à chaque appel sans cache, et 0,002 $ en lecture de cache. Sur 1 000 appels, 40 $ contre 2 $ pour cette partie, hors écritures. Plus ton contexte fixe est gros par rapport à la question variable, plus l'écart pèse.
Passer en traitement par lots (Batch API)
Beaucoup de tâches n'ont pas besoin d'une réponse en direct : générer 500 descriptions produit, analyser un mois de verbatims clients, classer un export de tickets. On les envoie pourtant à l'API synchrone, au prix plein, par habitude.
Tu regroupes ces requêtes et tu les envoies par la Batch API. La page des prix annonce 50 % de réduction sur l'entrée et sur la sortie. D'après la page du traitement par lots, la plupart des lots se terminent en moins d'une heure et un lot expire s'il n'est pas traité en 24 heures. La page des prix précise aussi que les multiplicateurs du cache se cumulent avec la remise des lots.
Tout ton volume non urgent passe à moitié prix, avec un délai pour seul prix. C'est le bon endroit pour les analyses de fond régulières.
Maîtriser le contexte et le plafond de sortie
Deux fuites silencieuses gonflent une facture sans qu'on les voie.
La première : on empile dans le contexte des documents entiers, des historiques complets, des résultats d'outils bruts, dont la plupart ne servent pas à la réponse. Chaque token envoyé est facturé en entrée, à chaque appel.
La seconde : max_tokens est un plafond, pas une consigne de longueur. Il coupe la réponse quand elle l'atteint, il ne la rend pas plus courte. Avec la réflexion, ce plafond couvre la réflexion et le texte ensemble, donc le baisser trop te coupe en pleine réponse.
Ce que tu fais :
- Élague le contexte : n'envoie que ce qui sert la requête. Récupère les bons passages (recherche, résumé d'historique) au lieu de tout envoyer.
- Demande la longueur voulue dans le prompt (« réponds en 3 puces », « JSON strict, sans commentaire »), et garde
max_tokenscomme garde-fou. - Recalibre tes estimations quand tu changes de génération de modèle : le nouveau tokenizer produit environ 30 % de tokens en plus pour le même texte, d'après la page des prix.
C'est le levier le moins glamour. Pour savoir lequel de ces cinq leviers compte vraiment chez toi, passe à la mesure.
Mesurer avant d'optimiser
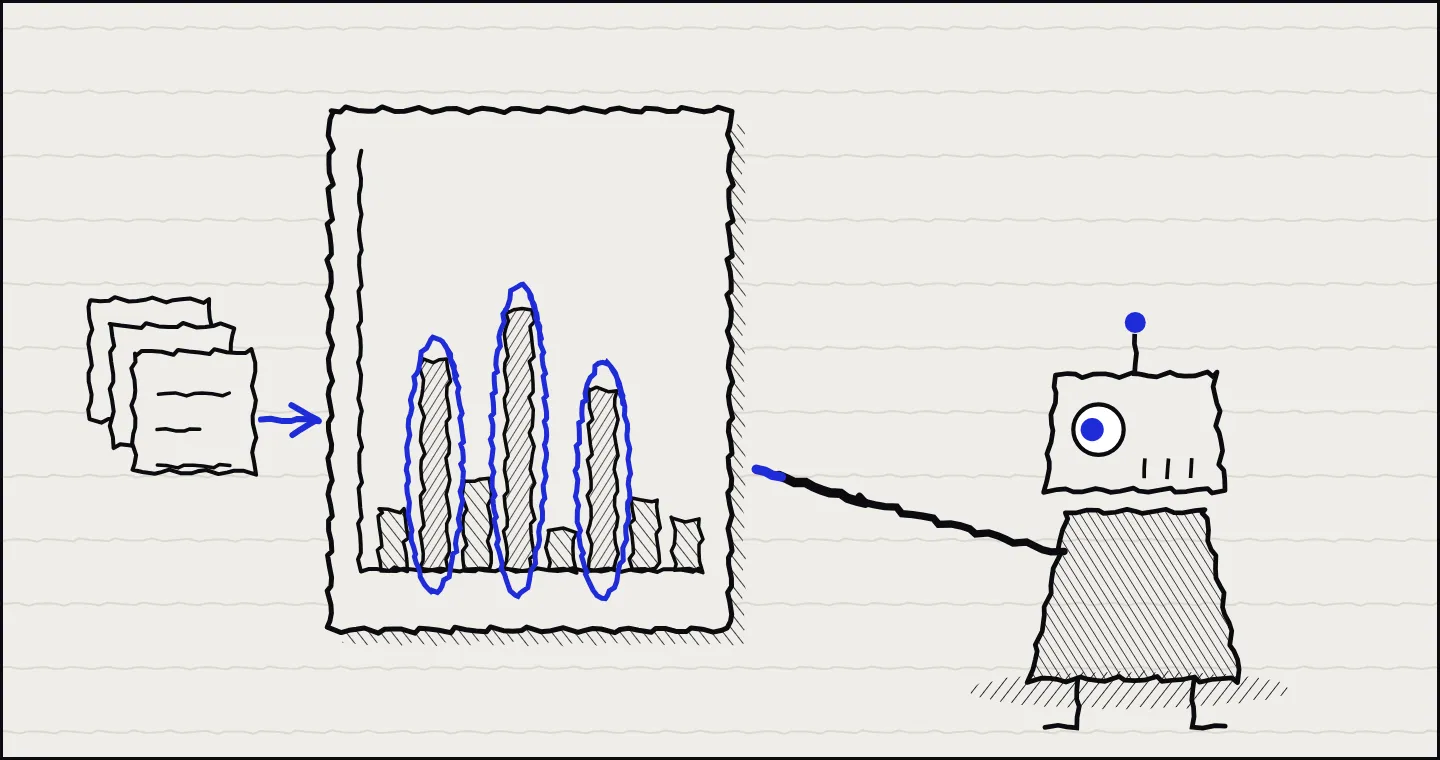
Tu ne peux pas piloter ce que tu ne mesures pas. Si tu ne regardes que la facture mensuelle, tu découvres un dérapage un mois trop tard. Le champ usage renvoyé à chaque appel donne pourtant tout en temps réel : tokens d'entrée, tokens de sortie, écritures et lectures de cache.
import json

def logger_usage(fonction, modele, usage):
    # les champs de cache peuvent valoir None selon la réponse
    print(json.dumps({
        "fonction": fonction,
        "modele": modele,
        "entree": usage.input_tokens,
        "sortie": usage.output_tokens,
        "cache_ecriture": usage.cache_creation_input_tokens,
        "cache_lecture": usage.cache_read_input_tokens,
    }))

# après chaque appel : logger_usage("support-email", "claude-sonnet-5-5", response.usage)
- Logge le
usagede chaque appel avec une étiquette (quelle fonction, quel modèle, quel type de tâche). - Agrège par jour et par fonction dans un simple tableau.
- Repère les trois sources de coût qui pèsent le plus, et applique les leviers 1 à 5 dans cet ordre.
Dans l'exemple de l'agence, ce tableau montre quelle fonction de l'assistant brûle le budget avant de toucher à quoi que ce soit. Tu passes d'une facture subie à une facture pilotée : tu vois une dérive en quelques heures, et tu choisis un modèle sur des chiffres.
Checklist finale
0 sur 7
Et maintenant ?
Une facture d'API ne dérape pas à cause d'un seul réglage : c'est le modèle, l'effort, le cache et le contexte qui, ensemble, décident de ce que tu paies. Le plus utile reste de savoir où part l'argent avant de toucher à quoi que ce soit.
La suite logique, c'est arbitrer coût et performance entre modèles IA, avec Gemini en exemple : la même question, tâche par tâche, avec un jeu de test pour décider. Si tu fais tourner des agents en arrière-plan, leur consommation se mesure de la même façon, et le tuto sur les agents de code montre ce qu'on peut leur confier. Pour la facture complète d'un projet IA, il y a aussi les trois coûts cachés d'un projet IA. Je publie ce genre de mode d'emploi dans ma newsletter, tu peux t'inscrire juste en dessous.


