Ton outil IA peut être coupé du jour au lendemain : le plan de repli à prévoir
Par Anis Hammouche·15 juin 2026
Si ton activité repose sur l'API d'un seul fournisseur d'IA, tu as un point unique de panne que personne ne chiffre. Le prévoir coûte une couche de code et un deuxième modèle testé, pas une migration. Voici comment t'y prendre quand tu es freelance ou une petite agence, à partir d'un cas concret.
Prends Atelier Lumen, une agence web de quatre personnes (un cas inventé, comme tout ce qui concerne l'agence dans cet article). Elle vend à ses clients un assistant qui répond aux questions des visiteurs de leur site, branché sur l'API d'un seul modèle. Un vendredi soir, l'accès à ce modèle s'arrête. Ni panne, ni facture impayée : une décision venue d'ailleurs. Le lundi matin, quatre clients appellent, et personne à l'agence ne sait en combien de temps elle peut rebrancher autre chose.
Ce scénario a un précédent réel. Le 12 juin 2026, Anthropic a reçu une directive du gouvernement américain, invoquant la sécurité nationale, qui demandait de suspendre l'accès à Fable 5 et Mythos 5 pour toute personne de nationalité étrangère. Anthropic a désactivé les deux modèles pour l'ensemble de ses utilisateurs, comme le racontent le Blog du Modérateur et Siècle Digital. Fable 5 avait été lancé trois jours plus tôt. Sur AI Gateway, la passerelle de Vercel, l'accès n'est revenu que le 1er juillet 2026, près de trois semaines après.
Ce qui peut couper un fournisseur, hors panne
Indisponible ne veut pas seulement dire en panne. Un modèle peut disparaître pour des raisons qui n'ont rien à voir avec sa fiabilité technique :
- Une décision réglementaire ou politique, comme la coupure de Fable 5 et Mythos 5.
- Le retrait d'une version par l'éditeur, qui pousse ses clients vers un modèle plus récent et débranche l'ancien.
- Un changement de conditions d'usage qui exclut ton cas d'usage ou ton secteur.
- Une rupture de la relation contractuelle décidée côté fournisseur.
Dans chacun de ces cas, ton service s'arrête sans que tu aies fait la moindre erreur. Le problème n'est pas le modèle que tu as choisi. C'est de n'en avoir qu'un, sans porte de sortie.
Trois questions pour chiffrer le risque, usage par usage
Tous tes usages de l'IA ne méritent pas le même repli. Pour chacun, réponds à trois questions :
- Quel impact si ce modèle s'arrête demain matin ? Un confort en moins, ou un client qui perd des demandes ?
- Combien de temps pour basculer sur une alternative, avec ton code tel qu'il est aujourd'hui ?
- Qui décide de la disponibilité de ce service, et selon quelles règles qui peuvent changer sans toi ?
Voilà ce que ça donne pour Atelier Lumen, usage par usage :
| Usage chez Atelier Lumen | Si ça s'arrête | Repli à prévoir |
|---|---|---|
| Assistant sur le site d'un client | Le client perd des demandes de visiteurs et appelle | Niveaux 1 et 2 : couche unique et alternative testée |
| Résumé des briefs en interne | L'équipe le fait à la main un jour ou deux | Niveau 1 : couche unique suffit |
| Brouillons de newsletters | Gêne légère, rien ne casse | Niveau 1, ou rien au début |
Le niveau de précaution suit l'enjeu, comme pour une assurance : une fonction de confort peut s'arrêter une journée sans dommage, un service que tu factures à un client ne le peut pas.
Trois niveaux de repli, du plus simple au plus engageant
Un plan de repli ne veut pas dire tout réécrire ni tout rapatrier sur ton propre serveur.
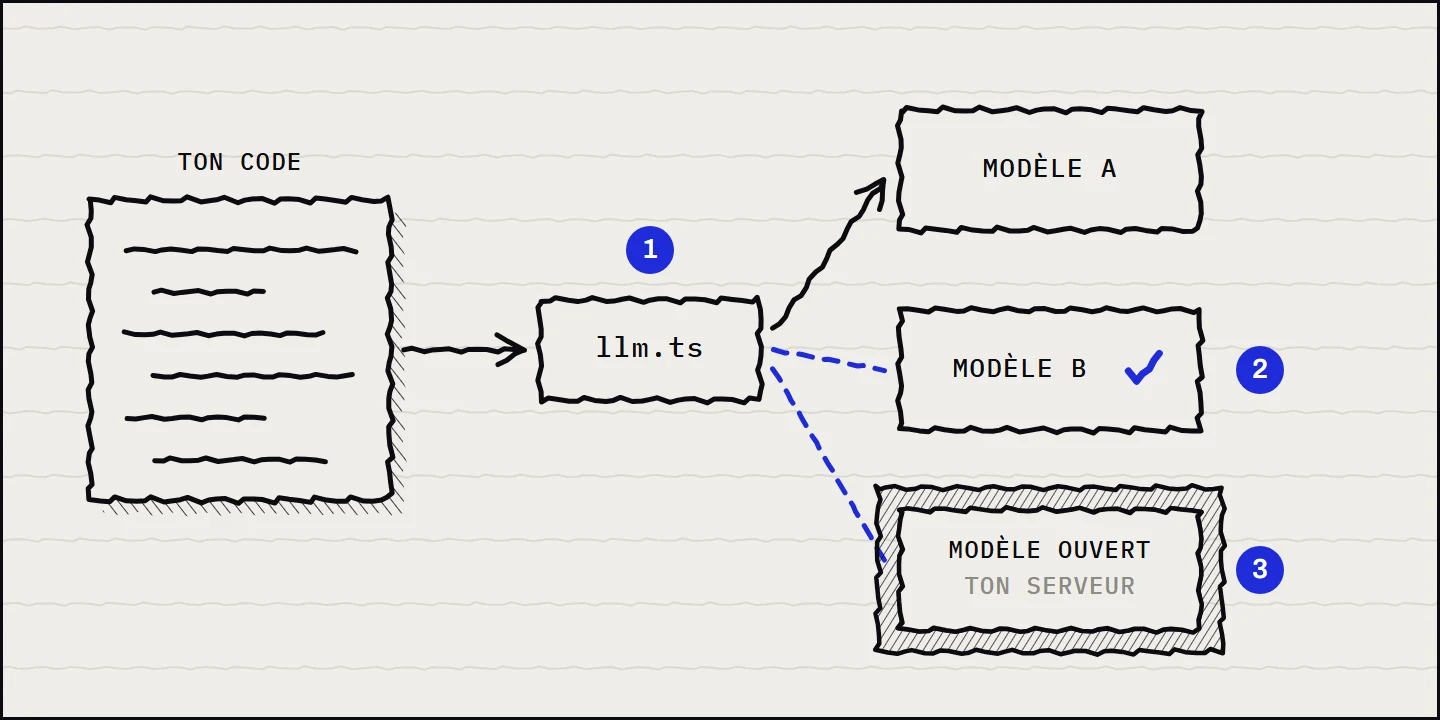
Niveau 1 : isoler l'appel au modèle derrière une seule fonction. Au lieu d'appeler l'API du fournisseur à vingt endroits de ton code, tu passes par une fonction qui, elle, appelle le modèle. Le jour où tu changes de fournisseur, tu modifies ce seul fichier. Mon estimation, sans mesure derrière : quelques heures à quelques jours selon l'état de ton code, bien moins qu'une migration faite dans l'urgence. Le squelette tient en quelques lignes :
// llm.ts : le seul fichier qui connaît les fournisseurs
type Fournisseur = (prompt: string) => Promise<string>

export async function demanderAuModele(
  prompt: string,
  fournisseurs: Fournisseur[],
): Promise<string> {
  for (const appeler of fournisseurs) {
    try {
      return await appeler(prompt)
    } catch (erreur) {
      console.error('Fournisseur indisponible, bascule sur le suivant', erreur)
    }
  }
  throw new Error('Aucun fournisseur disponible')
}
Niveau 2 : garder une alternative testée, pas seulement identifiée. Avoir un deuxième nom dans un document ne suffit pas. Une alternative n'est un repli que si elle a déjà tourné sur tes vraies demandes, avec tes prompts, et que tu connais son comportement. Passe dix demandes réelles dans le second modèle et compare les réponses à celles du premier : les différences de ton, de format ou de précision se règlent le jour même, pas pendant la crise. Certaines passerelles font la bascule pour toi : le changelog de Vercel conseille d'utiliser les « model fallbacks » d'AI Gateway, qui essaie chaque modèle d'une liste dans l'ordre quand le premier refuse la requête.
Niveau 3 : héberger en propre ce qui ne peut pas s'arrêter. Faire tourner un modèle ouvert sur ton infrastructure supprime la dépendance à un tiers. Ce niveau demande un vrai investissement, et un modèle ouvert est souvent moins capable qu'un modèle commercial récent sur les tâches difficiles : teste-le sur tes cas avant de t'engager. Il ne se justifie que quand l'enjeu le commande, par exemple pour des documents clients qui ne doivent pas sortir. J'ai détaillé cette option dans le backend d'un produit IA souverain, avec son coût d'exploitation réel.
| Niveau | Ce que tu mets en place | Quand le choisir |
|---|---|---|
| 1. Couche unique | Une fonction entre ton code et le modèle | Toujours, dès le premier déploiement |
| 2. Alternative testée | Un deuxième modèle déjà branché et comparé | Service facturé à un client, arrêt coûteux |
| 3. Auto-hébergé | Un modèle ouvert sur ton infrastructure | Fonction critique ou données qui ne peuvent pas sortir |
Une fiche de repli à remplir par usage
Remplis-la une fois par usage, dans l'ordre du tableau. Dix minutes par usage suffisent pour savoir où tu en es.
Usage : [ex. assistant de réponses sur le site d'un client]
Fournisseur actuel et modèle : [nom du fournisseur, nom du modèle]
Si ça s'arrête : [confort en moins, ou client qui perd des demandes]
Appel isolé dans un seul fichier : [oui, non]
Alternative choisie : [fournisseur et modèle]
Alternative testée sur de vraies demandes : [oui le (date), non]
Où sont mes prompts et mes données : [dans mon dépôt, dans l'outil du fournisseur]
Qui bascule, et comment : [nom, étapes]
La dépendance ne s'arrête pas au modèle
Changer de modèle ne suffit pas si tout le reste reste captif. Si tes prompts, tes données de référence et ta logique métier vivent dans le format propriétaire d'un seul outil, tu restes dépendant même avec un modèle de rechange. Garde tes prompts dans ton dépôt, tes données dans un format que tu sais exporter. Si ton automatisation vit dans un outil comme n8n, Make ou Zapier, note-le dans ta fiche : ce choix d'outil est lui aussi une dépendance. La question de savoir où partent tes données en est une autre, que je traite dans l'alternative française à ChatGPT.
Si tu as déjà une automatisation ou un agent branché sur un seul fournisseur, ajouter la couche du niveau 1 et tester un deuxième modèle est un petit projet de dev que je prends.
Ce qu'il faut retenir
- Le risque n'est pas la qualité du modèle, c'est la dépendance à un point unique.
- Une coupure peut venir d'une décision politique, d'un retrait de version ou d'un changement de conditions, sans aucune faute de ta part.
- Trois niveaux : une couche unique, une alternative testée, l'auto-hébergement pour le critique.
- L'action concrète : avant de brancher un usage important sur un modèle, isole l'appel dans une fonction et teste un deuxième modèle.
Questions fréquentes
Faut-il prévoir un repli pour chaque usage de l'IA ?
Non. Le niveau de précaution suit l'impact. Un brouillon de newsletter qui peut attendre une journée ne demande rien de particulier. Un service que tu factures à un client mérite au minimum une couche unique et une alternative testée. Classe tes usages avec le tableau ci-dessus avant de décider.
La couche unique, c'est compliqué à mettre en place ?
C'est un travail simple s'il est fait au départ, et pénible s'il est ajouté sous la pression. Il s'agit de faire passer tous les appels au modèle par une seule fonction. Je ne donne pas de durée type sans connaître ton code : compte les endroits où tu appelles le fournisseur, ça te donne l'ordre de grandeur.
Un modèle auto-hébergé vaut-il un modèle commercial ?
Pas toujours sur les tâches les plus exigeantes. Pour certaines fonctions simples, il peut suffire, avec l'avantage de supprimer la dépendance à un tiers. La décision se prend cas par cas, en testant sur tes vraies demandes et en mettant le résultat en face du coût d'hébergement.
Comment savoir quels usages traiter en premier ?
Pose une question pour chacun : si ce service s'arrête demain matin, est-ce un inconfort ou un blocage ? Les blocages passent en premier, surtout quand ils touchent un client.
Sources
- Blog du Modérateur, Le gouvernement des États-Unis force Anthropic à couper l'accès à Fable 5 et Mythos 5, juin 2026
- Siècle Digital, Anthropic contraint de couper en urgence ses IA jugées les plus dangereuses, 15 juin 2026
- Vercel, Claude Fable 5 access restored on AI Gateway, 1er juillet 2026
La suite logique, c'est de savoir où partent les données de tes clients quand tu utilises ChatGPT. Je publie ce genre de décryptage dans ma newsletter, tu peux t'inscrire juste en dessous.