Le vrai blocage de l'IA n'est pas le modèle, c'est l'accès à tes données
Par Anis Hammouche·22 juin 2026
Le vrai blocage d'un projet IA, ce n'est pas le modèle, c'est l'accès à tes données. Si tes clients sont dans un outil de réservation, tes paiements dans une autre application et ton suivi dans un tableur tenu à la main, aucun modèle ne te répondra juste, même le meilleur du moment.
Prends Malik, coach sportif indépendant (un personnage inventé, comme les chiffres qui suivent). Il voit une démo : quelqu'un branche un modèle sur trois documents, pose une question, obtient une réponse propre. Il en conclut que le sujet est réglé et veut un assistant qui répond à ses clients : « C'est quand, ma prochaine séance ? Où en est mon programme ? » Six semaines plus tard, le projet est à l'arrêt, et personne ne sait vraiment dire pourquoi. La technologie marchait pourtant, en démo.
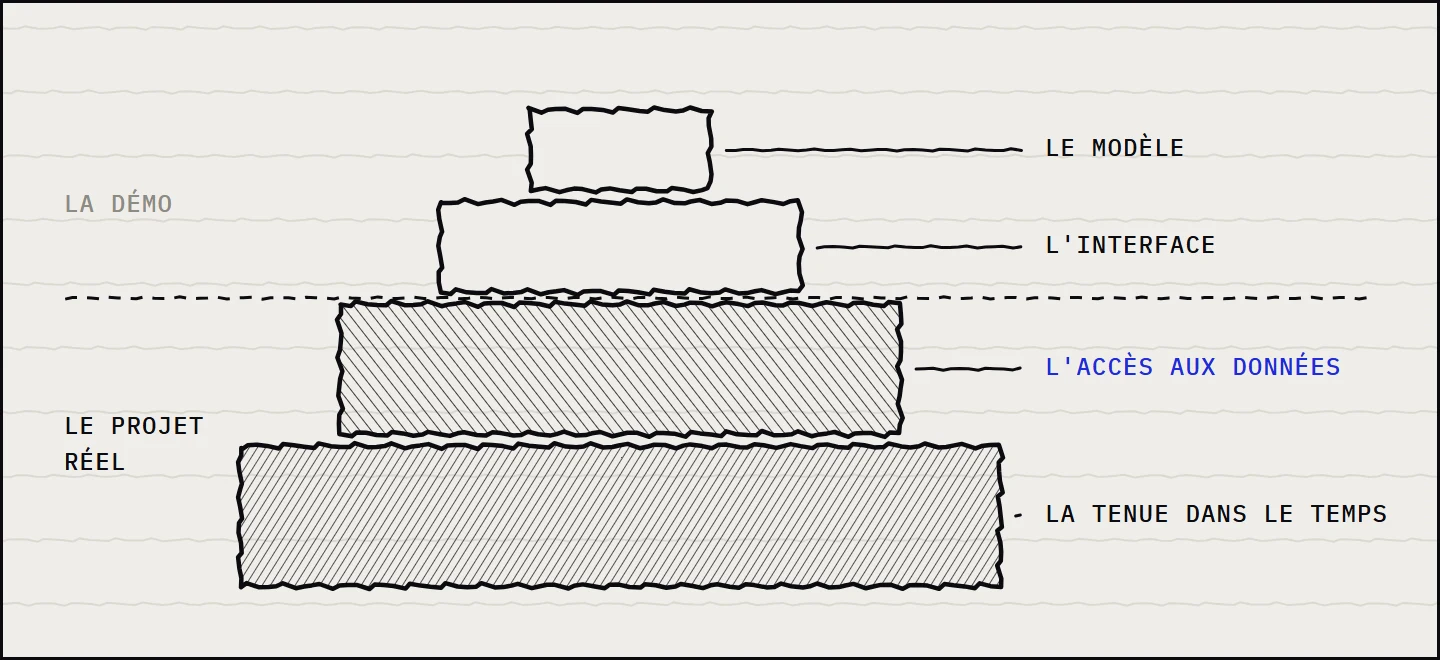
Ce scénario est courant : on croit que le travail consiste à choisir le bon modèle. En réalité, le modèle est devenu la partie facile. Le vrai chantier, celui que la démo masque, c'est l'accès aux données.
Pourquoi le modèle n'est plus le problème
Les modèles généralistes actuels savent résumer, classer, extraire, reformuler et répondre à un niveau largement suffisant pour la plupart des besoins d'un indépendant ou d'une petite agence. L'écart entre deux fournisseurs sérieux se voit moins sur tes cas réels que dans les classements techniques, qui ne ressemblent pas à ton quotidien.
Conséquence directe : quand un projet IA déçoit, c'est rarement parce que le modèle n'était pas assez bon. C'est parce qu'on lui a donné les mauvaises données, des données sales, ou aucune donnée fiable. Le modèle répond toujours quelque chose. S'il répond à côté, regarde d'abord ce que tu lui as donné à lire.
Là où les projets calent vraiment
La démo réussit parce qu'elle triche, sans mauvaise intention. On choisit trois documents propres, récents, bien écrits, et on pose une question dont on connaît la réponse. Le passage au réel révèle ce que la démo avait évité. Chez Malik, quatre choses coincent.
Les données vivent dans trois outils. Les séances sont dans l'outil de réservation, les paiements dans une application de facturation, le suivi des charges et des mesures dans un tableur. Aucun ne parle à l'autre. Le modèle ne sait pas où chercher, parce que personne ne lui a dit où est la vérité.
L'export est impossible ou partiel. Dans cet exemple inventé, l'outil de réservation exporte la liste des clients, mais pas l'historique des séances. Sans export propre, la donnée reste enfermée : tu ne peux pas la donner au modèle sans la recopier. Si tu choisis un outil aujourd'hui, teste son export avant de t'abonner.
Le fichier Excel tenu à la main est un désordre qu'on ne voit plus. Le même client y apparaît sous trois écritures, « Sofia M. », « Sofia Martin » et « S. Martin ». Sur 120 lignes (un chiffre inventé), une trentaine sont des doublons de ce genre. Une colonne mélange des kilos et des pourcentages, une autre des dates en lettres et en chiffres. Le modèle ne tranche pas, il restitue le désordre que tu lui donnes.
Les droits ne sont pas posés. Un coach garde des informations qui touchent à la santé de ses clients, comme une blessure ou un poids. Les données concernant la santé font partie des données sensibles que définit la CNIL, et selon le contexte une blessure ou un poids peuvent en relever : mieux vaut les traiter avec prudence. Un assistant qui répond à Sofia avec l'historique d'un autre client n'est pas un gain de temps, c'est un incident en attente. Je détaille ce qu'il vaut mieux ne pas coller dans un outil grand public dans où vont tes données et celles de tes clients.
Les quatre couches d'un projet IA, de la plus visible à la plus déterminante
| Couche | Ce que c'est | Effort réel pour une petite activité | Là où ça casse |
|---|---|---|---|
| Le modèle | Le moteur qui génère la réponse | Faible, c'est un choix | Rarement |
| L'interface | Le chat ou le bouton dans l'outil | Moyen | Parfois, par manque d'usage |
| L'accès aux données | Relier le modèle aux bonnes sources, à jour, avec les bons droits | Élevé | Presque toujours |
| La tenue dans le temps | Qui garde les données à jour et propres | Continu | À retardement |
La démo se joue sur les deux premières lignes. Le projet réel se gagne ou se perd sur les deux dernières. C'est l'inverse de l'attention qu'on leur donne au départ.
Comment cadrer l'accès aux données avant de brancher l'IA
Ce travail se cadre, et il ne demande pas de refondre tes outils. Il demande de répondre à quelques questions précises avant d'écrire la première ligne de code. Remplis cette fiche pour chaque information dont ton assistant a besoin.
Information dont l'IA a besoin : [ex. historique des séances d'un client]
Où se trouve la version qui fait foi : [outil ou fichier]
Export possible : [oui en CSV, oui partiel, non]
État : [à jour, doublons, formats mélangés, champs vides]
Qui a le droit de la voir : [moi seul, le client concerné, mon équipe]
Qui la tient à jour : [nom et rythme]
Quelques règles pour la remplir.
- Un seul endroit fait foi par information. Si deux outils portent le tarif d'une séance, décide lequel gagne. Cette décision vaut plus que le choix du modèle.
- Nettoie seulement ce dont le cas d'usage a besoin. Un tri ciblé sur les données du projet suffit. Inutile de ranger tout ton tableur pour démarrer.
- Pose les périmètres d'accès avant de connecter quoi que ce soit. L'outil doit respecter qui a le droit de voir quoi.
- Nomme quelqu'un qui tient la donnée à jour. Sans ça, l'outil se dégrade en silence, et tu le découvres à la première mauvaise réponse devant un client.
Le même blocage dans une petite agence
Studio Trame, agence de communication de trois personnes (inventée), voudrait un assistant qui prépare le point hebdomadaire de chaque client. Les briefs sont dans des e-mails, le planning dans un outil de notes, les factures dans une application à part. Le client le plus ancien existe sous deux noms, avec deux interlocuteurs différents. Avant de parler de modèle, l'agence doit décider quel outil fait foi pour le nom d'un client, et qui le corrige. Mon estimation, sans mesure derrière : une demi-journée de travail plutôt qu'un projet de plusieurs mois, et ça conditionne tout le reste. La réflexion est la même que pour choisir un outil vertical plutôt qu'un assistant générique : un outil cadré n'a de valeur que branché sur des données propres.
L'erreur qui coûte le plus cher
L'erreur classique est de changer de modèle quand le projet déçoit. On passe d'un fournisseur à l'autre en espérant que le suivant comprendra mieux. Le résultat ne bouge pas, parce que le problème n'a jamais été là.
Tant que tes données sont dispersées, contradictoires et sans responsable, le meilleur modèle du monde restituera fidèlement ton désordre. L'inverse est vrai aussi : une fois l'accès cadré, même un modèle modeste donne des résultats que tu utilises vraiment. Le levier n'est pas dans le moteur, il est dans ce que tu lui donnes à lire. Quand l'accès demande de relier plusieurs outils, de nettoyer un historique et de brancher un agent, c'est du travail d'automatisation ou de développement sur mesure, et c'est un des projets que je prends.
Questions fréquentes
Faut-il un grand chantier de gestion des données avant de faire de l'IA ?
Non. C'est même le meilleur moyen de ne jamais démarrer. Le cadrage se fait au périmètre de la tâche, pas à l'échelle de toute ton activité. Tu prépares les données dont cette tâche précise a besoin, rien de plus, et tu élargis ensuite si la suivante le justifie.
Comment savoir si mes données sont prêtes pour l'IA ?
Pour chaque information utile à la tâche, peux-tu désigner un seul endroit à jour et fiable, dont tu sais exporter le contenu ? Si oui, tu es prêt. Sinon, la fiche ci-dessus te montre ce qu'il reste à faire avant de brancher le modèle.
Le choix du modèle n'a donc aucune importance ?
Il en a, mais moins qu'on ne le croit, et plus tard dans la réflexion. Commence par un modèle généraliste sérieux, concentre l'effort sur l'accès aux données, et ne reviens sur le choix du modèle que si un besoin précis le justifie, par exemple une contrainte de confidentialité ou de coût.
Combien de temps pour cadrer cet accès ?
Ça dépend de l'état de tes outils. Remplir la fiche pour une tâche précise se fait en une soirée. Nettoyer un historique ou obtenir un export qui n'existe pas peut prendre bien plus. Je ne donne pas de durée type sans connaître les outils : commence par la fiche, elle te dit si le chantier est petit ou gros.
Une fois l'accès réglé, reste à savoir si l'outil te rapporte : le ROI d'un outil IA se calcule en quelques lignes. Je raconte la suite dans ma newsletter, juste en dessous.