Payer moins cher son IA : le bon modèle pour chaque tâche (prix d'octobre 2026)
Par Anis Hammouche·2 novembre 2026
Prends un freelance ou une petite agence qui fait trier 1 000 messages clients par mois par une IA. Avec Opus 5.5, un grand modèle d'Anthropic, la facture est d'environ 6 $ ; avec Haiku 5.5, un petit modèle du même éditeur, d'environ 0,15 $, soit quarante fois moins (les hypothèses du calcul sont plus bas). Pour payer moins cher ton IA, arrête de prendre le modèle le plus puissant par défaut : si le petit modèle réussit ta tâche, c'est lui qu'il te faut.
Le réglage tient en deux choix : un abonnement fixe ou une facturation à l'usage (l'API), puis le modèle le moins cher qui réussit ta tâche. Les prix cités ci-dessous viennent des pages officielles des fournisseurs, à la date d'octobre 2026.
Abonnement fixe ou API : le premier choix
Un abonnement te donne un montant fixe par mois, avec un plafond d'usage selon l'offre. Une API te facture chaque token envoyé et reçu. Un token est un petit morceau de texte, plus court qu'un mot : un mot français en fait souvent plus d'un.
Le choix dépend de ta façon de travailler. Si tu passes tes journées dans une interface de chat, l'abonnement est presque toujours plus simple. Si tu branches l'IA dans un outil ou un script qui tourne sans toi, c'est l'API qui s'impose.
| Formule | Prix affiché (octobre 2026) | Pour qui |
|---|---|---|
| Claude Pro | 20 $ par mois, ou 17 $ par mois avec un abonnement annuel (200 $ facturés d'avance) | Usage quotidien en chat, volume modéré |
| Claude Max | À partir de 100 $ par mois | Usage intensif, plafond nettement supérieur à Pro |
Sources : tarifs Claude et documentation tarifaire de l'API Anthropic. Les montants sont en dollars, hors taxes, tels qu'affichés. La conversion et la TVA restent à ta charge.
Les prix API, modèle par modèle
Les prix API s'expriment par million de tokens, en entrée puis en sortie. Le tableau reprend quelques modèles représentatifs d'Anthropic.
| Modèle | Entrée (par million de tokens) | Sortie (par million de tokens) | Fournisseur |
|---|---|---|---|
| Haiku 5.5 (jusqu'à 100 000 tokens) | 0,10 $ | 0,50 $ | Anthropic |
| Sonnet 5.5 | 2 $ | 10 $ | Anthropic |
| Opus 5.5 | 4 $ | 20 $ | Anthropic |
Deux détails de ces grilles pèsent plus que le prix affiché. La sortie coûte plus cher que l'entrée : chez Anthropic, cinq fois plus, donc une réponse longue pèse plus lourd qu'un prompt long. Anthropic applique aussi 50 % de réduction sur les appels batch, adaptés aux tâches qui n'ont pas besoin d'une réponse immédiate.
Un calcul concret
Imaginons que tu tries 1 000 messages clients par mois. Chaque message fait 500 tokens en entrée et la réponse de tri 200 tokens en sortie. Ce sont des hypothèses à remplacer par tes chiffres réels.
- Avec Haiku 5.5 : 0,5 million de tokens en entrée à 0,10 $, soit 0,05 $ ; 0,2 million en sortie à 0,50 $, soit 0,10 $. Total : 0,15 $.
- Avec Opus 5.5 : 0,5 million en entrée à 4 $, soit 2 $ ; 0,2 million en sortie à 20 $, soit 4 $. Total : 6 $.
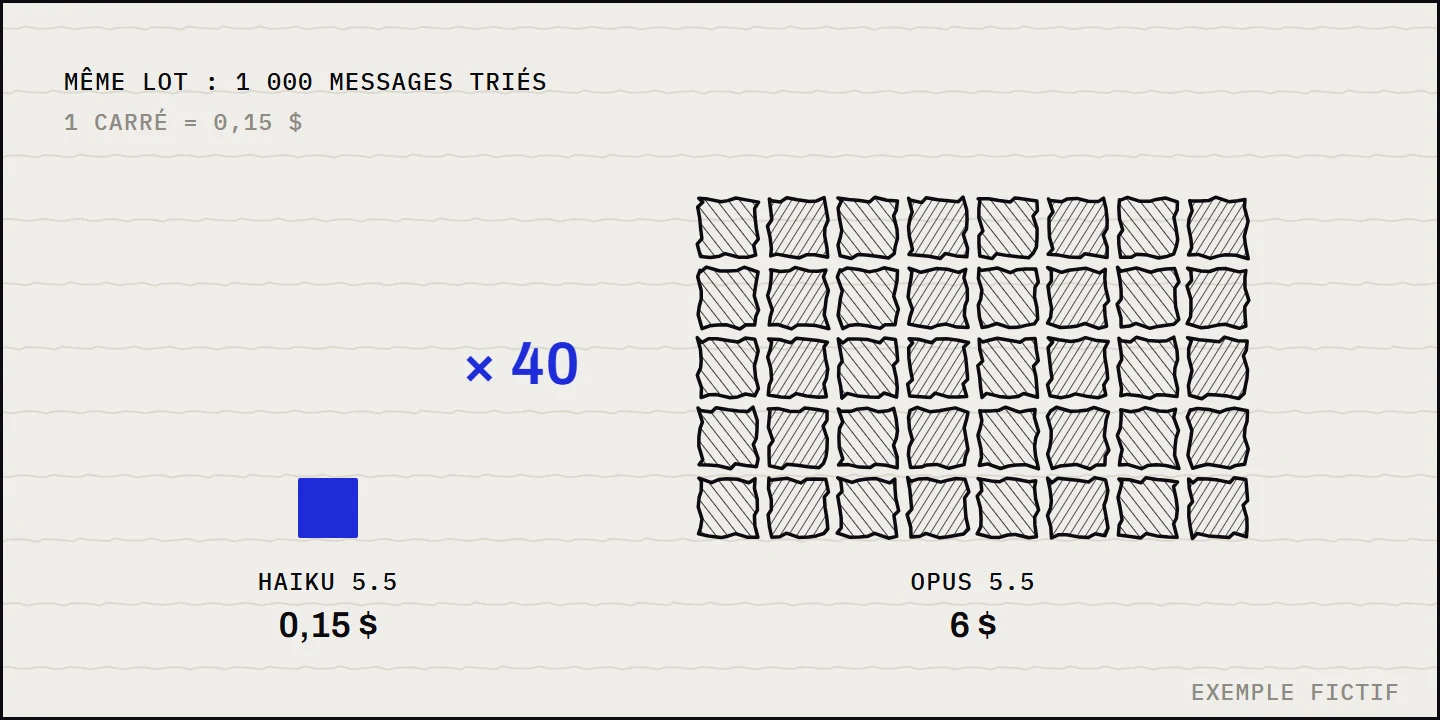
Pour le même travail, le grand modèle coûte ici quarante fois plus cher. Si tu passes ces appels en batch, avec la réduction de 50 % indiquée par Anthropic, le total tombe à 0,075 $ avec Haiku 5.5 et à 3 $ avec Opus 5.5. L'écart reste de quarante contre un. Le calcul ne vaut que si le petit modèle réussit ta tâche, d'où l'étape suivante. Tu peux refaire ce calcul avec ce court script :
def cout_usd(tokens_entree: int, tokens_sortie: int, prix_entree: float, prix_sortie: float) -> float:
    """Coût en dollars, prix exprimés par million de tokens."""
    return tokens_entree / 1_000_000 * prix_entree + tokens_sortie / 1_000_000 * prix_sortie


print(cout_usd(500_000, 200_000, 0.10, 0.50))  # Haiku 5.5 : 0.15
print(cout_usd(500_000, 200_000, 4, 20))       # Opus 5.5 : 6.0
Comment choisir, étape par étape
- Liste tes tâches récurrentes. Trois à cinq suffisent : tri, résumé, rédaction, code, analyse.
- Pour chacune, prends vingt cas réels et lance le plus petit modèle disponible.
- Juge les réponses avec une consigne écrite, pas au feeling. Ce prompt fait le travail de relecture :
Tu es un relecteur strict. Voici une demande client et la réponse produite.
Réponds OK si la réponse est exacte, complète et au ton juste.
Sinon réponds ÉCHEC, suivi d'une phrase qui explique le problème.

Demande : {demande}
Réponse : {reponse}
- Si dix-huit réponses sur vingt sont bonnes et que les deux échecs se corrigent avec une meilleure consigne, garde le petit modèle.
- Monte de gamme seulement pour les tâches qui échouent encore. Si la réponse n'est pas urgente, passe en batch.
Les pièges qui font grimper la facture
- Le cache de prompts garde en mémoire un contexte déjà envoyé pour ne pas le payer en entier à chaque appel. Anthropic tarifie la lecture et l'écriture de ce cache, avec une durée de 5 minutes par défaut. Il est utile si tu renvoies toujours le même gros document. Il ne sert à rien si chaque appel est différent.
- L'inférence limitée aux États-Unis. Anthropic applique un tarif multiplié par 1,1 à cette option. Ne l'active que si ta donnée l'exige.
- Le mode rapide. Pour Opus 5.5, il est nettement plus rapide mais facturé deux fois le tarif standard. Garde-le pour les cas où le délai compte vraiment.
- Les grands contextes répétés. Un historique de conversation qui grossit se paie à chaque tour. Résume-le au lieu de tout renvoyer.
Ce que les pages officielles ne disent pas
Une grille tarifaire officielle donne un prix, pas une réponse. Deux limites sont à garder en tête.
- Elle ne couvre qu'un fournisseur à la fois. Cet article ne compare pas OpenAI : si tu l'utilises, ajoute ses tarifs depuis sa page officielle et note la date à laquelle tu les relèves.
- Elle donne un prix par modèle, pas par usage. Vérifie le tarif du modèle précis que tu veux, pas la moyenne du fournisseur, et regarde si le mode batch s'applique à ta tâche.
Le batch est un mode d'appel asynchrone : tu envoies un lot de requêtes, la réponse arrive plus tard, et le fournisseur la facture moins cher.
Ce qui change vite
Les fournisseurs précisent que leurs prix peuvent changer à tout moment. Note la date et le prix de chaque modèle que tu utilises, et revérifie les pages officielles une fois par mois.
Questions fréquentes
Le plus petit modèle suffit-il toujours ? Non. Il suffit pour les tâches simples et répétitives, à condition de passer ton test sur des cas réels. Pour un raisonnement long ou du code difficile, teste un modèle plus grand et garde-le seulement là où il fait la différence.
Abonnement ou API : comment trancher ? Compare ton usage réel d'un mois type au prix mensuel de l'abonnement. Si la facture API de ce mois dépasse le prix de l'abonnement, l'abonnement gagne. Sinon, l'API te coûte moins cher et te laisse payer à l'usage.
Ces prix resteront-ils valables longtemps ? Non. Ils sont datés d'octobre 2026, et les fournisseurs peuvent les modifier.
Faut-il choisir un fournisseur unique pour simplifier ? Ce n'est pas obligatoire. Un fournisseur par type de tâche peut être plus économique. Le plus simple reste de garder un tableau à jour avec la tâche, le modèle et son prix.
Pour aller plus loin, lis d'abord le vrai coût de l'IA et les trois coûts cachés.